𝗔𝗫𝗜 𝗥𝗘𝗚𝗜𝗦𝗧𝗘𝗥 𝗦𝗟𝗜𝗖𝗘 │ READY 경로는 짧아졌는데, 전송률은 왜 절반일까?
AXI Register Slice one-stage versus two-deep buffering with registered READY
타이밍을 맞추려고 AXI W channel 중간에 register slice를 넣었습니다. 그런데 파형을 보니 보내는 쪽은 계속 VALID이고 받는 쪽도 계속 READY인데, 데이터가 한 clock 걸러 한 번씩 나갑니다. 어떤 설정을 봐야 할까요?
먼저 기준부터 짚어보죠. clock edge에서 VALID와 READY가 모두 1이면 그 channel에서 한 번의 전송이 성립합니다. 다음 edge에서도 전송이 성립하면 매 cycle 한 beat입니다. 중간에 전송이 비는 cycle이 bubble입니다.
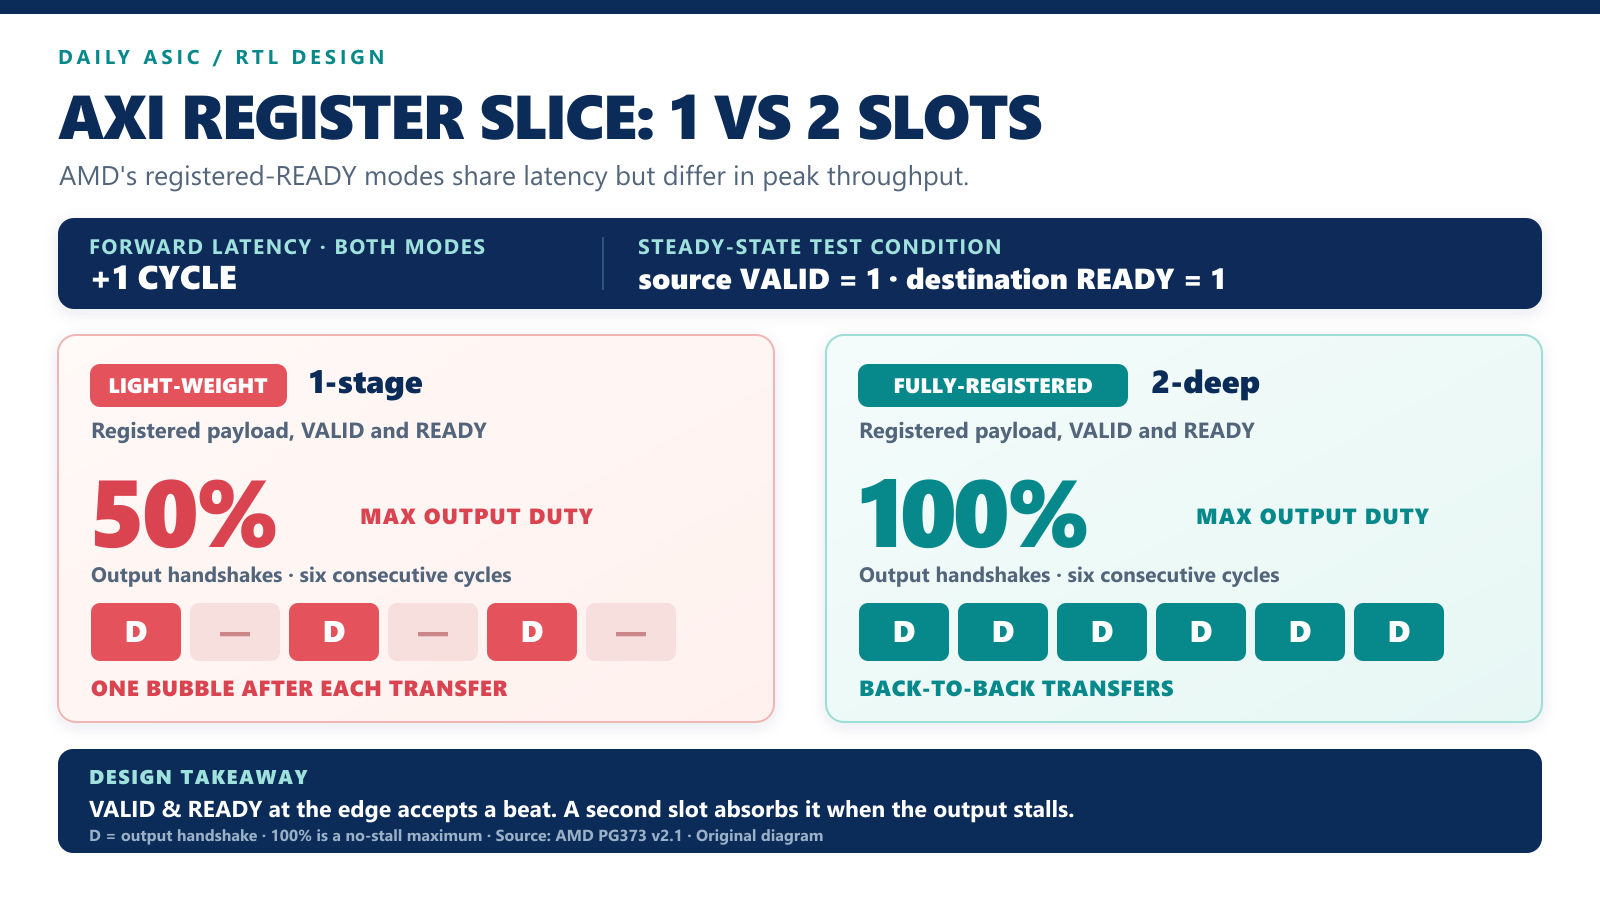
AMD AXI Register Slice의 Light-Weight와 Fully-Registered는 둘 다 forward latency가 1 cycle입니다. 첫 beat가 도착하는 시간만 보면 비슷해 보이죠. 하지만 계속 보내면 차이가 납니다.
Light-Weight는 1-stage pipeline 구조로 자원을 아끼는 대신, 전송할 때마다 다음 cycle에 bubble이 하나 생깁니다. 보내는 쪽이 계속 VALID이고 받는 쪽이 계속 READY여도 최대 두 cycle에 한 beat입니다. Fully-Registered는 2-deep FIFO를 사용해 연속 전송이 가능하고, 같은 조건에서 최대 매 cycle 한 beat까지 처리합니다.
왜 두 칸이 필요할까요? READY까지 register로 끊으면 받는 쪽이 멈췄다는 사실이 보내는 쪽에 즉시 전달되지 않습니다. 앞 beat가 아직 출력에 남아 있는데, 이미 허용된 다음 beat가 들어올 수 있습니다. 이때 다음 beat를 보관할 여유가 있어야 데이터 손실 없이 연속 전송할 수 있습니다.
설계에서 볼 것은 latency 한 숫자가 아닙니다. W/R처럼 beat가 이어지는 경로라면 실제 handshake 간격과 목표 대역폭을 확인해야 합니다. AW/AR/B도 발행률이 높다면 같은 검토가 필요합니다. 뒷단이 멈췄다가 다시 움직일 때 beat가 빠지거나 중복되지 않는지도 파형으로 보세요.
한 가지 주의할 점: 최대 50%는 모든 1-stage buffer에 적용되는 법칙이 아니라 AMD의 Light-Weight 모드 특성입니다. 직접 만든 slice나 다른 IP에는 그 구현의 handshake 동작을 따로 확인해야 합니다.
근거: AMD AXI Register Slice Product Guide PG373
https://docs.amd.com/r/en-US/pg373-axi-register-slice/Light-Weight
https://docs.amd.com/r/en-US/pg373-axi-register-slice/Fully-Registered
https://docs.amd.com/r/en-US/pg373-axi-register-slice/Performance
Arm AMBA AXI and ACE Protocol Specification, IHI 0022H, §A3.2.1
https://developer.arm.com/-/media/Arm%20Developer%20Community/PDF/IHI0022H_amba_axi_protocol_spec.pdf